Rate Limit
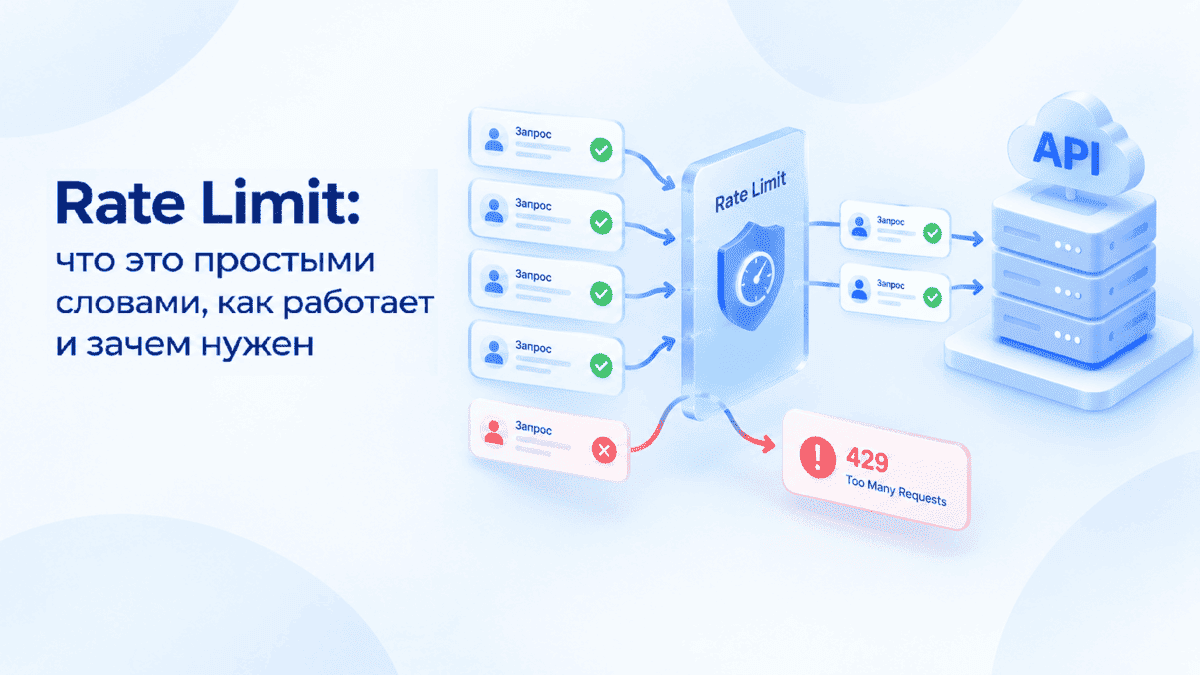
Rate limit (ограничение частоты запросов) — это механизм в веб-разработке и сетевой безопасности, который контролирует количество запросов от пользователя, IP-адреса или приложения к серверу за определённый промежуток времени. Если запросов становится слишком много, система ограничивает дальнейшие обращения. Для HTTP API распространённая реакция — ошибка 429 Too Many Requests. Rate limiting защищает API от перегрузок, DDoS-атак и злоупотреблений, а также помогает справедливо распределять ресурсы между клиентами.
В этой статье разберём, что такое rate limit и rate limiting, как работают алгоритмы (Token Bucket, Leaky Bucket, Fixed Window, Sliding Window), что означают RPS, RPM и TPM, почему возникает 429 и как правильно обработать превышение лимита.
Содержание
- Что такое rate limit простыми словами
- Что такое rate limiting и чем он отличается от rate limit
- Как работает rate limit
- Зачем нужен rate limiting
- Какие ограничения бывают в API: RPS, RPM, QPS, RPD, TPM и concurrency
- Что происходит при превышении rate limit
- Ошибка 429 Too Many Requests: причины и что делать
- Что такое Retry-After и rate limit headers
- Как избежать ошибки 429 и правильно обработать rate limit
- Алгоритмы rate limiting: Fixed Window, Sliding Window, Token Bucket, Leaky Bucket
- Rate limit, quota, throttling и concurrency: в чём разница
- Как реализовать и настроить rate limit для API
- Правовые аспекты rate limiting
- FAQ: частые вопросы о rate limit
Что такое rate limit простыми словами
Rate limit — это установленный лимит на количество запросов, которые клиент может отправить за период. Например: «100 запросов в минуту на один API-ключ» или «10 запросов в секунду с одного IP». Простыми словами, это «турникет» на входе: он пропускает определённое количество посетителей и не даёт одному клиенту заблокировать сервис для всех остальных.
Лимит может задаваться для разных объектов:
- IP-адреса — ограничение запросов от одного адреса;
- пользователя — отдельный лимит для каждого пользователя;
- API-ключа — ограничение для конкретного ключа доступа;
- endpoint — лимит для отдельного метода API;
- приложения — общий лимит для клиентского приложения;
- всего API — общий лимит входящего потока.
Конкретный способ идентификации клиента зависит от API. RFC 6585 не устанавливает единственный способ подсчёта запросов: ограничение может рассчитываться на уровне ресурса, сервера или группы серверов.
Что такое rate limiting и чем он отличается от rate limit
Rate limit — это установленное правило, например «100 запросов в минуту». Rate limiting — это механизм, с помощью которого система контролирует и ограничивает поток запросов. Rate limiter — компонент, который применяет ограничение.
| Термин | Что означает | Пример |
|---|---|---|
| Rate limit | Установленный лимит | 100 запросов/мин |
| Rate limiting | Механизм контроля лимита | Система отслеживает и отклоняет превышение |
| Rate limiter | Компонент, применяющий ограничение | Middleware, API Gateway, отдельный сервис |
Проще говоря: rate limit — правило, rate limiting — процесс его применения.
Как работает rate limit
Rate limit работает так: система отслеживает обращения клиента, считает запросы и сравнивает их с установленным лимитом. Пока ограничение не достигнуто — запросы разрешаются; после превышения применяется заданное правило.
Упрощённая схема:
Клиент → HTTP-запрос → API → проверка rate limit → разрешить или ограничить
Работа rate limiting включает пять шагов:
- Определяется клиент. Система выбирает идентификатор: IP, пользователь, API-ключ, приложение.
- Определяется ресурс. Что именно ограничивать: количество запросов, токены, одновременные операции.
- Ведётся учёт. Rate limiter хранит информацию о количестве обращений или доступных ресурсах.
- Запрос сравнивается с лимитом. Если ресурс доступен — запрос передаётся дальше. Если нет — применяется политика ограничения.
- Система возвращает результат. Запрос может быть принят, отклонён, поставлен в очередь или обработан с ограничением скорости.
При лимите 10 запросов в секунду:
Запрос 1  → разрешён
Запрос 2  → разрешён
...
Запрос 10 → разрешён
Запрос 11 → лимит достигнут → ограничение
Для HTTP API один из распространённых вариантов ответа — 429 Too Many Requests. Но поведение зависит от конкретного API.
Что именно считает rate limiter:
- количество запросов;
- частоту запросов;
- количество токенов;
- количество одновременно выполняющихся запросов;
- обращения к отдельному endpoint;
- суммарную нагрузку клиента.
Поэтому выражение «rate limit = количество запросов в минуту» удобно для простого объяснения, но технически оно шире.
Зачем нужен rate limiting
Rate limiting нужен для контроля нагрузки на API, защиты ресурсов и предсказуемого распределения вычислительных ресурсов между клиентами.
| Задача | Зачем нужен лимит |
|---|---|
| Контроль нагрузки | Не позволяет большому потоку запросов перегрузить сервер |
| Защита API | Ограничивает чрезмерную активность отдельных клиентов |
| Стабильность сервиса | Сохраняет доступность при пиковых нагрузках |
| Распределение ресурсов | Не даёт одному клиенту потребить весь ресурс |
| Защита от злоупотреблений | Ограничивает автоматические и слишком частые обращения |
| Управление доступом | Позволяет задавать разные лимиты для пользователей |
| Контроль стоимости | Важен для API, где запросы потребляют платные квоты |
Rate limiting особенно важен для публичных API, интеграций, API Gateway, авторизованных приложений и сервисов с большим количеством клиентов.
Где используется rate limiting:
- в REST API и GraphQL API;
- на API Gateway и в reverse proxy;
- в middleware приложений;
- в сервисах авторизации и при входе пользователей;
- в платёжных API;
- в AI и LLM API;
- в публичных веб-сервисах.
Какие ограничения бывают в API: RPS, RPM, QPS, RPD, TPM и concurrency
API может ограничивать не только количество запросов в минуту. На практике используются лимиты по скорости (RPS, QPS), количеству за период (RPM, RPD), токенам (TPM, TPD) и одновременным операциям (concurrency).
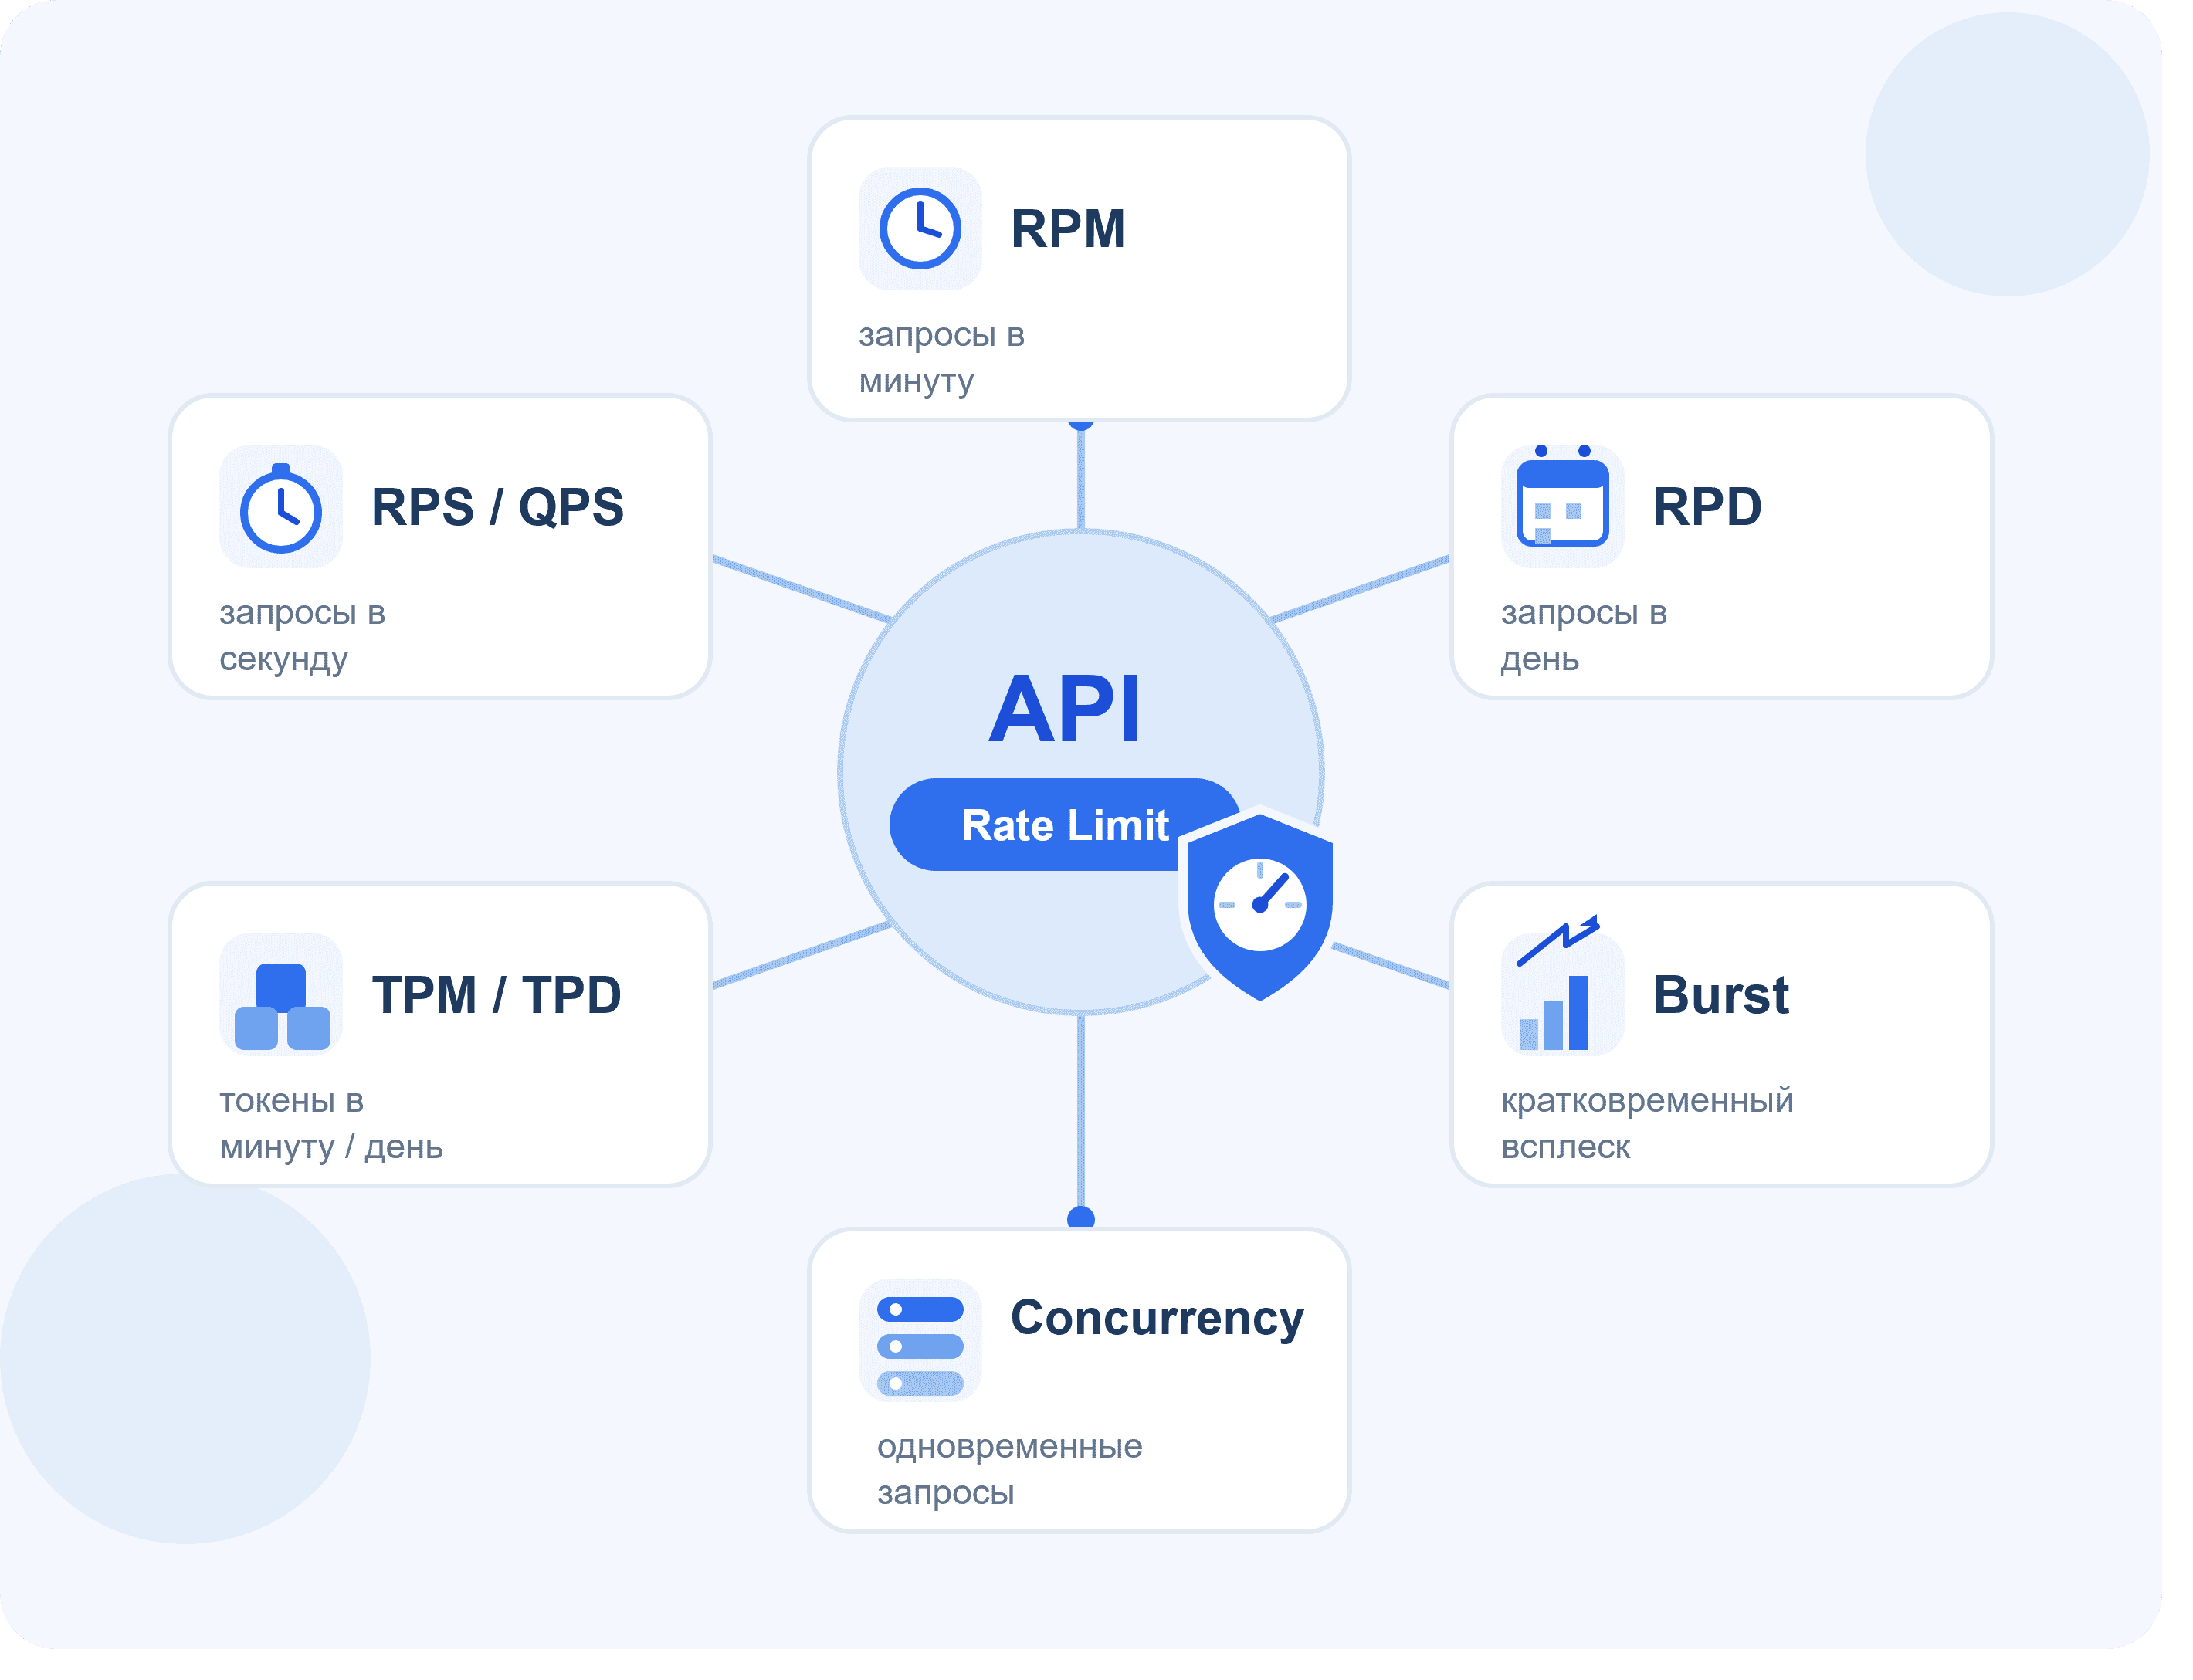
Шпаргалка по обозначениям
| Обозначение | Расшифровка | Что измеряет | Пример |
|---|---|---|---|
| RPS | Requests Per Second | HTTP-запросы к API в секунду | 10 RPS |
| QPS | Queries Per Second | Запросы к базе данных или поиску в секунду | 100 QPS |
| RPM | Requests Per Minute | HTTP-запросы к API в минуту | 600 RPM |
| RPD | Requests Per Day | HTTP-запросы к API в день | 10 000 RPD |
| TPM | Tokens Per Minute | Токены в минуту | 100 000 TPM |
| TPD | Tokens Per Day | Токены в день | 1 млн TPD |
| Concurrency | Concurrency Limit | Одновременно обрабатываемые запросы | 10 |
Лимиты по скорости: RPS и QPS
RPS (Requests Per Second) — количество HTTP-запросов к API или веб-сервису за секунду. QPS (Queries Per Second) — количество запросов к базе данных, поисковому движку или внутреннему сервису за секунду.
Это разные метрики: RPS измеряет нагрузку на API «на входе», QPS — нагрузку на базу данных или поиск «внутри системы». Например, если клиент отправляет 100 HTTP-запросов в секунду, а каждый из них вызывает 3 запроса к базе данных, RPS = 100, а QPS = 300.
В rate limiting для API обычно используют именно RPS: RPS = 10 означает, что клиенту разрешено не более 10 HTTP-запросов за секунду. При этом 10 RPS не означает строго один запрос каждые 100 мс — поведение зависит от алгоритма rate limiting.
Лимиты по количеству за период: RPM и RPD
RPM (Requests Per Minute) — количество запросов за минуту. RPM = 600 означает лимит 600 запросов за окно. Как и в случае с RPS, 600 RPM не обязательно означает равномерный поток: при некоторых алгоритмах клиент может отправить часть запросов burst-пакетом, а затем дождаться восстановления лимита.
RPD (Requests Per Day) — количество запросов за день. RPD = 10 000 означает, что клиенту доступно не более 10 000 запросов за сутки. Такой лимит больше похож на ограничение общего объёма использования, тогда как RPS и RPM контролируют интенсивность запросов.
Лимиты по токенам: TPM и TPD
В API, работающих с токенизированными данными (например, LLM API), может использоваться ограничение по токенам: TPM (Tokens Per Minute) и TPD (Tokens Per Day).
Такие лимиты нужны, потому что два запроса могут быть одинаковыми по количеству HTTP-вызовов, но сильно отличаться по объёму обрабатываемых данных. Один запрос с большим промптом может «съесть» столько же токенов, сколько десять коротких.
Лимит одновременных запросов: concurrency
Concurrency limit ограничивает количество запросов, которые могут одновременно находиться в обработке. Например, API может разрешать 1000 запросов в минуту, но одновременно обрабатывать не более 10.
Это отличается от RPM или RPS: клиент может выполнить до 1000 запросов за минуту, но не должен держать более 10 операций одновременно. Concurrency limiter защищает сервер от ситуации, когда все ресурсы заняты длительными операциями и новые запросы не могут быть обработаны.
Что такое burst в rate limiting
Burst — кратковременный всплеск запросов, который может быть разрешён rate limiter при сохранении общего правила. Например, ограничение 60 запросов в минуту, но алгоритм позволяет клиенту отправить несколько запросов сразу, а затем ограничивает поток.
Это важно при выборе алгоритма: фиксированное количество запросов за период не всегда означает равномерную скорость отправки. Token Bucket специально позволяет контролируемые bursts.
Несколько лимитов одновременно
Один API может использовать несколько лимитов одновременно:
10 RPS
600 RPM
100 000 TPM
10 concurrent requests
В такой системе запрос может упереться не в один универсальный rate limit, а в конкретное ограничение, которое было достигнуто первым. Поэтому при диагностике проблемы важно выяснить, какой именно лимит установлен и какой ресурс был исчерпан.
Что происходит при превышении rate limit
При превышении rate limit система применяет установленное правило: отклоняет запрос, временно ограничивает клиента, замедляет обработку или использует другой механизм контроля. Для HTTP API распространённый вариант — ответ 429 Too Many Requests.
При лимите 100 запросов в минуту на API-ключ:
Первые 100 запросов → разрешены
101-й запрос        → rate limit превышен → ограничение
Возможные варианты поведения:
| Поведение | Что происходит |
|---|---|
| Отклонение запроса | API не выполняет запрос и возвращает ошибку |
| HTTP 429 | Клиент получает 429 Too Many Requests |
| Временная блокировка | Новые обращения запрещаются на период |
| Очередь | Запрос помещается в очередь и обрабатывается позже |
| Throttling | Поток запросов замедляется |
| Комбинация | API одновременно ограничивает скорость и параллельные операции |
Превышение rate limit не всегда означает постоянную блокировку клиента. Конкретное поведение определяется политикой API.
Как понять, что rate limit превышен: первый признак — HTTP-ответ с ошибкой 429. Дополнительную информацию дают заголовки:
HTTP/1.1 429 Too Many Requests
Retry-After: 30

X-RateLimit-Limit: 100
X-RateLimit-Remaining: 0
X-RateLimit-Reset: 1760000000
Названия и состав таких заголовков зависят от конкретного API. X-RateLimit-* не следует воспринимать как единый обязательный набор: разные сервисы используют собственные форматы.
Ошибка 429 Too Many Requests: причины и что делать
Ошибка 429 Too Many Requests означает, что клиент отправил слишком много запросов за определённый период и сервер ограничил дальнейшие обращения. Код 429 стандартизирован RFC 6585 именно для этой ситуации.
Пример ответа:
HTTP/1.1 429 Too Many Requests
Content-Type: application/json
Retry-After: 30

{
  "error": "rate_limit_exceeded",
  "message": "Too many requests"
}
Почему возникает ошибка 429:
| Причина | Пример |
|---|---|
| Слишком много запросов в секунду | 50 RPS при лимите 10 RPS |
| Слишком много запросов в минуту | Превышен лимит 1000 RPM |
| Превышен лимит токенов | Запросы потребляют больше разрешённого TPM |
| Слишком много параллельных операций | Превышен concurrency limit |
| Один API-ключ на несколько приложений | Общий лимит быстро исчерпывается |
| Слишком частые retry | Клиент сам создаёт дополнительную нагрузку |
| Burst выше допустимого | Всплеск превышает возможности limiter |
Поэтому при постоянном получении 429 недостаточно просто «уменьшить количество запросов» — сначала нужно определить, какой именно лимит превышен.
Как понять, какой rate limit превышен:
- Посмотреть HTTP-код ответа.
- Проверить
Retry-After. - Проверить доступные rate-limit headers.
- Посмотреть тело ответа — API может указать тип превышенного ограничения.
- Сравнить фактические RPS/RPM с установленным лимитом.
- Проверить количество одновременно выполняющихся запросов.
- Если API работает с токенами — проверить TPM/TPD.
- Уточнить, не используется ли один API-ключ несколькими приложениями.
Что такое Retry-After и rate limit headers
Retry-After — HTTP-заголовок, который сообщает клиенту, когда следует повторить запрос. Rate limit headers — заголовки, через которые API сообщает о состоянии лимита.
Retry-After может содержать:
- количество секунд:
Retry-After: 30; - HTTP-дату:
Retry-After: Wed, 21 Oct 2026 07:28:00 GMT.
Если API возвращает Retry-After, клиенту следует учитывать это значение при повторной отправке запроса. RFC 9110 (HTTP Semantics) определяет Retry-After как отдельное поле, которое указывает, сколько времени ждать после получения 429.
Rate limit headers:
| Заголовок | Что показывает |
|---|---|
| Retry-After | Когда повторить запрос |
| X-RateLimit-Limit | Установленный лимит |
| X-RateLimit-Remaining | Оставшееся количество запросов |
| X-RateLimit-Reset | Время или момент обновления лимита |
Пример:
X-RateLimit-Limit: 100
X-RateLimit-Remaining: 17
X-RateLimit-Reset: 1760000000
Конкретные названия, единицы измерения и смысл заголовков зависят от API. Клиент должен ориентироваться прежде всего на документацию конкретного сервиса.
Стандарт IETF RateLimit Headers: IETF также разрабатывает стандартизированные поля для rate limiting: RateLimit-Limit, RateLimit-Remaining, RateLimit-Reset, RateLimit-Policy. Они описаны в Internet-Draft «RateLimit header fields for HTTP» и постепенно внедряются в API.
Как избежать ошибки 429 и правильно обработать rate limit
Чтобы реже получать 429, нужно контролировать скорость и параллельность запросов, учитывать установленные лимиты и не создавать лишнюю нагрузку повторными обращениями.
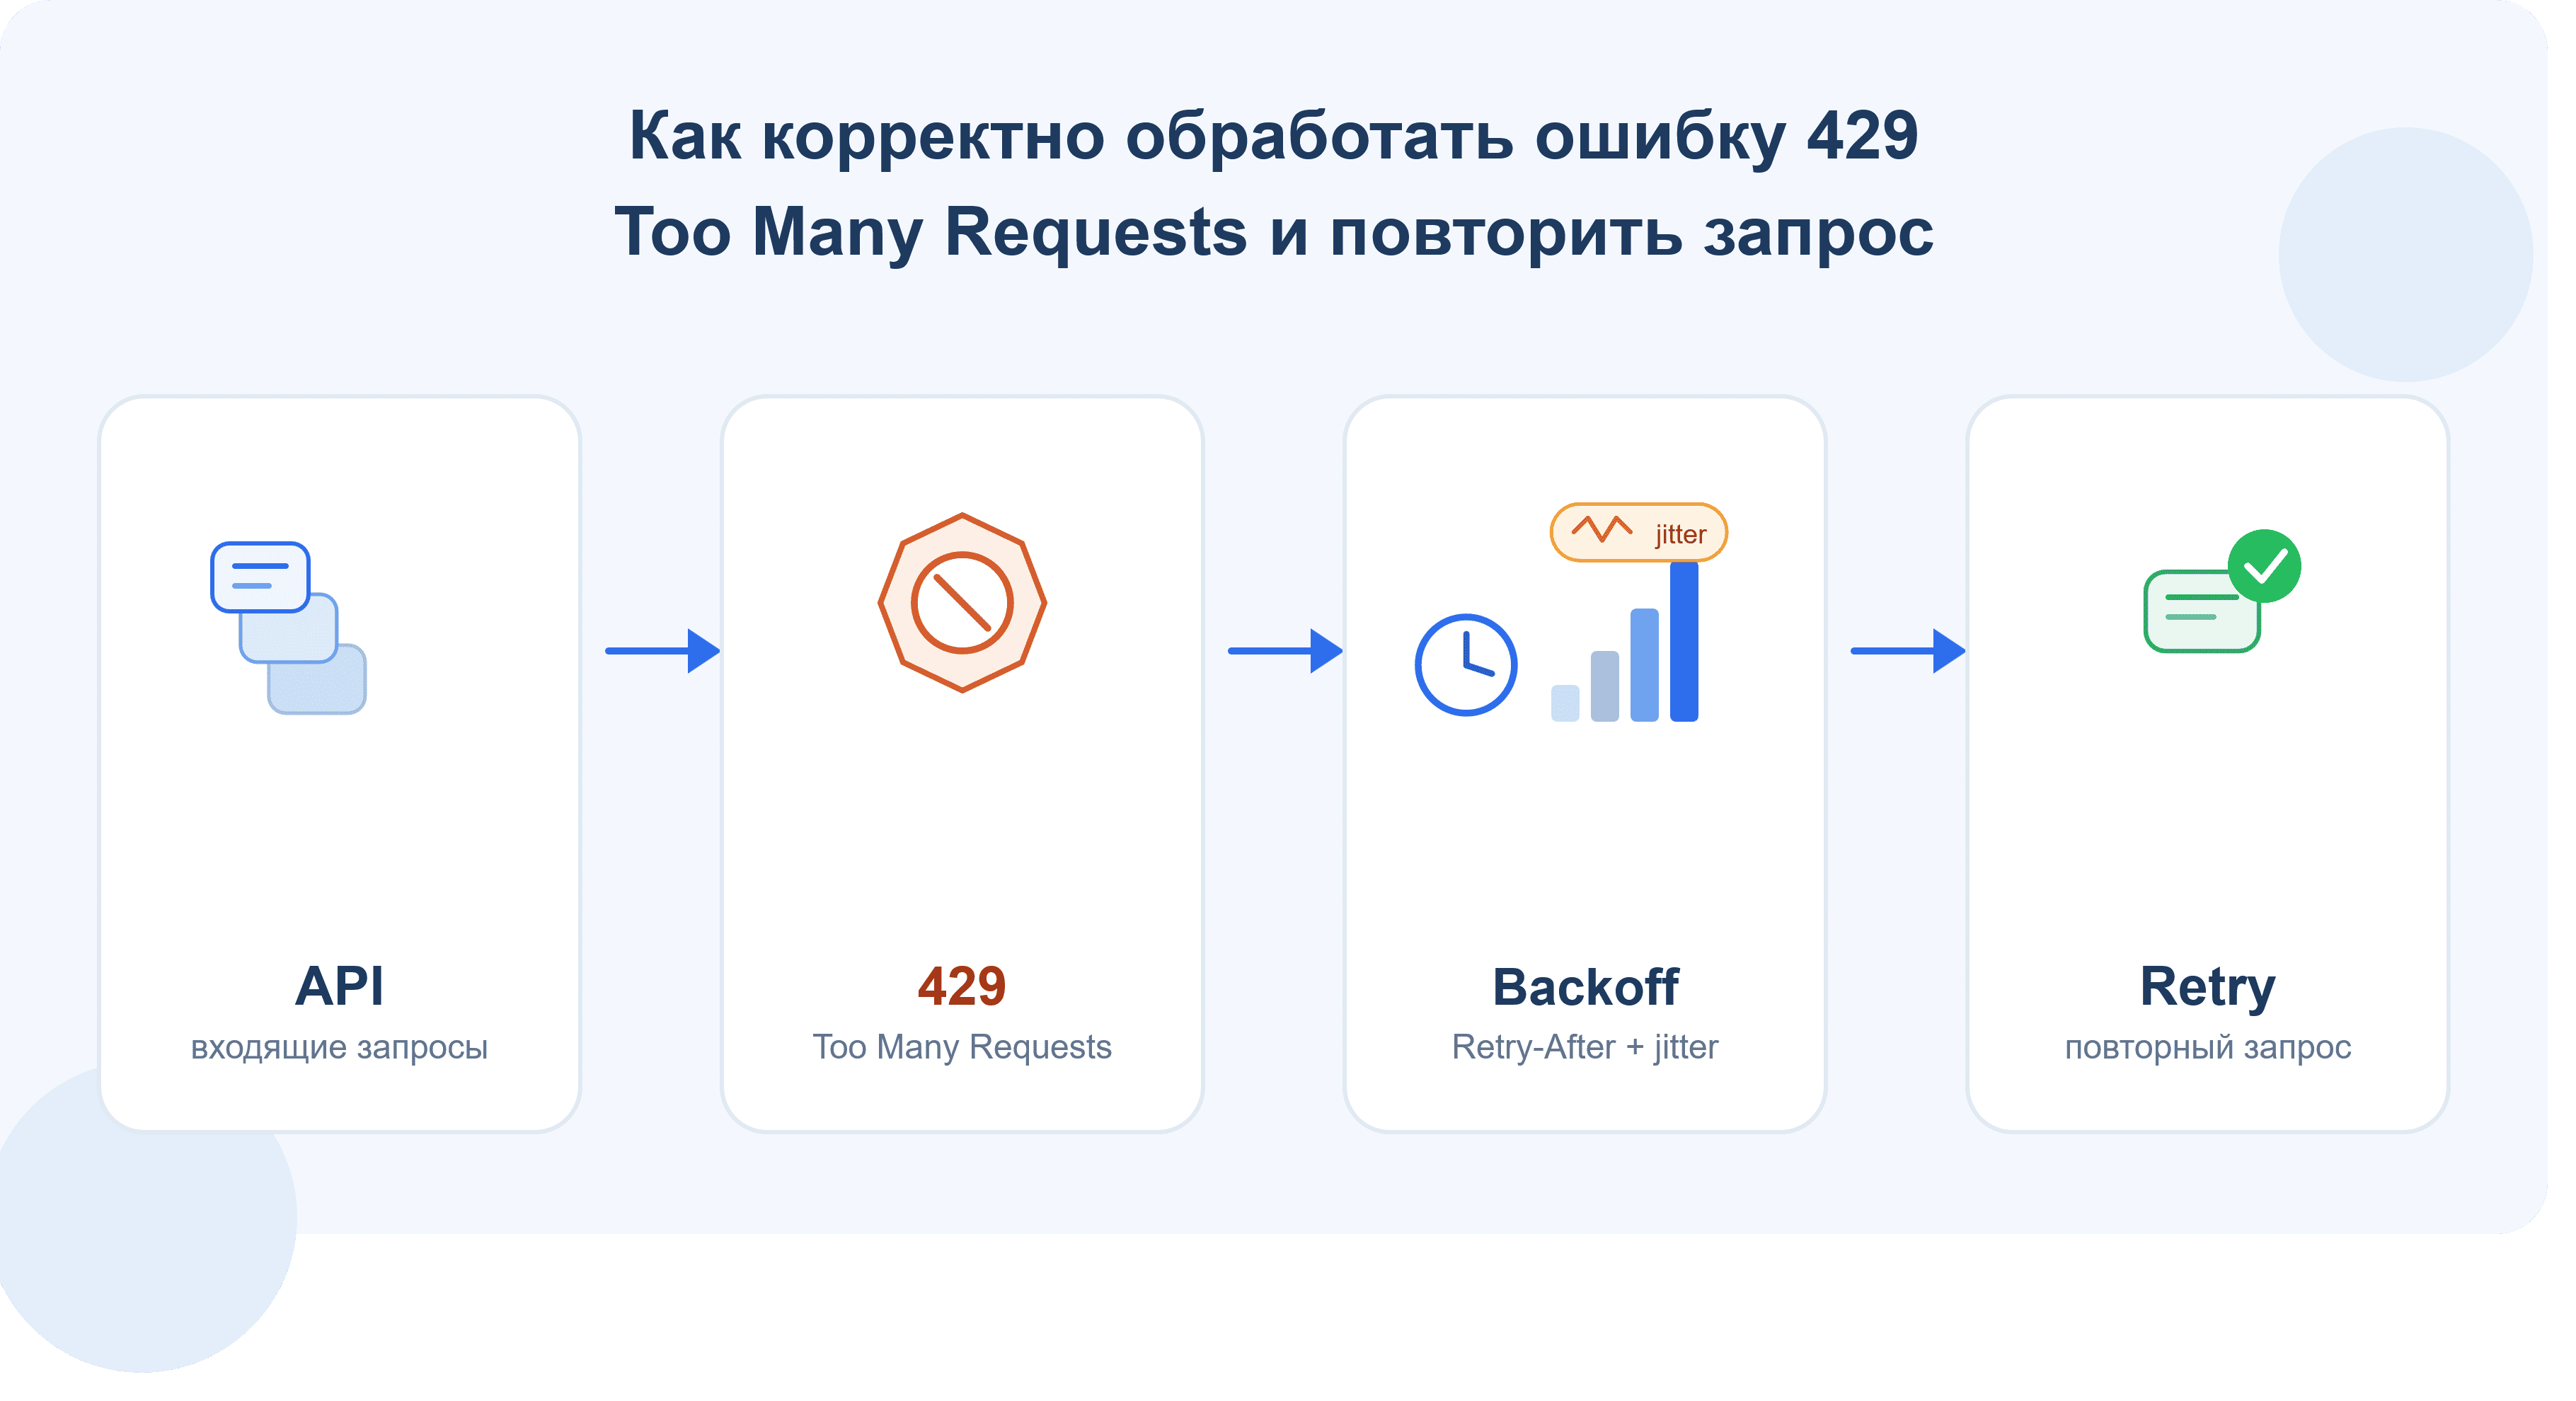
Основные способы избежать 429:
- Ограничить скорость запросов. Не отправлять запросы быстрее установленного RPS/RPM.
- Контролировать concurrency. Ограничить число одновременно выполняющихся операций.
- Использовать очередь. Если запросов временно больше допустимого — помещать их в очередь.
- Учитывать Retry-After. Если сервер сообщил время повторной попытки — использовать его.
- Не делать агрессивные retry. Повторная отправка сразу после 429 может снова привести к ограничению.
- Использовать exponential backoff. Увеличивать задержку между повторными попытками.
- Добавлять jitter. Небольшая случайная составляющая помогает избежать синхронных повторов.
- Сокращать ненужные запросы. Использовать кэширование и объединение запросов.
Правильная обработка rate limit:
Отправить запрос
      ↓
Получить ответ
      ↓
Успех? ── Да → продолжить
      │
      Нет
      ↓
429 Too Many Requests?
      ↓
Проверить Retry-After
      ↓
Подождать
      ↓
Повторить запрос
      ↓
При необходимости увеличить задержку
Что такое exponential backoff
Стратегия повторных попыток, при которой задержка между запросами постепенно увеличивается:
1-я попытка → ошибка → ждём 1 секунду
2-я попытка → ошибка → ждём 2 секунды
3-я попытка → ошибка → ждём 4 секунды
4-я попытка → ошибка → ждём 8 секунд
На практике задержка обычно имеет ограничение сверху, чтобы приложение не ожидало бесконечно долго.
Зачем нужен jitter
Jitter — случайная составляющая задержки. Без jitter большое количество клиентов может одновременно повторить запрос и создать новый всплеск нагрузки. С jitter время повторных попыток различается: 4,8 с, 5,3 с, 6,1 с, 5,7 с — и повторные запросы распределяются во времени.
Пример кода на Python (exponential backoff с jitter)
import time
import random
import requests

def request_with_backoff(url, max_retries=5):
    for attempt in range(max_retries):
        response = requests.get(url)
        if response.status_code == 429:
            retry_after = response.headers.get('Retry-After')
            if retry_after:
                wait = int(retry_after)
            else:
                wait = (2 ** attempt) + random.uniform(0, 1)
            time.sleep(wait)
        else:
            return response
    raise Exception("Max retries exceeded")
Алгоритмы rate limiting: Fixed Window, Sliding Window, Token Bucket, Leaky Bucket
Алгоритм rate limiting определяет, как система считает запросы, хранит состояние лимита и решает, разрешить или ограничить очередное обращение. Основные алгоритмы — Fixed Window, Sliding Window, Token Bucket и Leaky Bucket.
Fixed Window
Делит время на фиксированные интервалы:
10:00:00 — 10:01:00 → максимум 100 запросов
10:01:00 — 10:02:00 → максимум 100 запросов
Плюс — простая реализация. Минус — возможен двойной всплеск на границе окон.
Sliding Window
Оценивает количество запросов за скользящий интервал (например, последние 60 секунд). Позволяет более плавно контролировать поток и уменьшить проблему резких всплесков на границах.
Token Bucket
Использует условный запас токенов: каждый запрос расходует токен, токены постепенно добавляются с заданной скоростью.
Bucket: 10 токенов
Пополнение: 2 токена/сек
1 запрос = 1 токен
Пока в bucket есть токены — запросы разрешаются. Главное преимущество — контролируемый burst: клиент может временно отправить несколько запросов быстрее средней скорости, если накоплен запас токенов. Microsoft Azure использует Token Bucket для управления throttling: например, bucket size 250 токенов для чтения и пополнение 25 токенов в секунду.
Leaky Bucket
Моделирует поток запросов как очередь, которая обрабатывается с заданной скоростью:
много запросов → очередь → фиксированная скорость обработки → сервер
Подход удобен для сглаживания потока. Если очередь переполняется, новые запросы могут быть отклонены.
Сравнение алгоритмов
| Алгоритм | Принцип | Burst | Сильная сторона | Особенность |
|---|---|---|---|---|
| Fixed Window | Фиксированные окна | Возможен | Простота | Всплески на границе окон |
| Sliding Window | Скользящий интервал | Контролируемый | Плавное ограничение | Сложнее реализация |
| Token Bucket | Токены пополняются | Да | Контролируемые bursts | Нужно настроить bucket |
| Leaky Bucket | Очередь с заданной скоростью | Ограничен | Сглаживание потока | Может увеличивать задержку |
Как выбрать алгоритм
| Требование | Подход |
|---|---|
| Простое ограничение запросов за период | Fixed Window |
| Более равномерный контроль потока | Sliding Window |
| Нужны контролируемые bursts | Token Bucket |
| Нужно сгладить поток | Leaky Bucket |
| Нужно ограничить одновременные операции | Concurrency limiter |
Rate limit, quota, throttling и concurrency: в чём разница
Rate limit ограничивает скорость или частоту использования ресурса, quota — общий доступный объём, throttling — фактическое замедление обработки, а concurrency limit — число одновременно выполняющихся операций.
| Механизм | Что ограничивает | Пример |
|---|---|---|
| Rate limit | Частоту запросов | 100 запросов/мин |
| Quota | Общий объём за период | 1 млн запросов/месяц |
| Throttling | Скорость обработки | Снизить поток до 10 запросов/сек |
| Concurrency limit | Одновременные операции | Не более 10 одновременно |
Rate limit и quota. Главное различие — скорость против общего объёма. Клиент может иметь достаточную месячную quota, но получить ограничение rate limit уже через минуту слишком интенсивной работы.
Rate limit и throttling. Rate limit задаёт правило допустимой интенсивности. Throttling — механизм, который фактически ограничивает или замедляет обработку потока.
Rate limit и concurrency. Rate limit отвечает на вопрос «сколько запросов за период?». Concurrency — на вопрос «сколько операций одновременно?». Оба ограничения могут использоваться вместе.
Как реализовать и настроить rate limit для API
Rate limiting можно реализовать на уровне API Gateway, reverse proxy, middleware или в backend-приложении. В распределённых системах состояние счётчика выносят в общее быстрое хранилище, чтобы несколько экземпляров приложения использовали единое ограничение.
Типовая архитектура:
                ┌─ Backend 1
Клиенты → Gateway ├─ Backend 2
                 └─ Backend 3
                     │
                     ↓
               Rate limiter
                     │
                     ↓
              Shared storage
Rate limiter может находиться:
- в API Gateway;
- в reverse proxy;
- в middleware;
- в backend-приложении;
- в отдельном сервисе rate limiting.
Для распределённой системы важно, чтобы разные экземпляры приложения не вели независимые счётчики. Если каждый сервер считает по 100 запросов, фактический общий лимит может превратиться в 300. Для общего ограничения используется централизованное хранение состояния — например, Redis.
Что определить перед настройкой:
- Кого ограничивать — IP, пользователя, API-ключ, приложение.
- Что ограничивать — запросы, токены, concurrency.
- Какой лимит — RPS, RPM, TPM.
- Какой алгоритм — Fixed Window, Token Bucket и другие.
- Что делать при превышении — вернуть ошибку, поставить в очередь.
- Как информировать клиента — через HTTP-код, Retry-After, headers.
Пример правила:
Клиент:      API key
Лимит:       100 RPM
Burst:       до 10 запросов
Concurrency: 5
При превышении: HTTP 429
Retry-After: количество секунд ожидания
Примеры лимитов в реальных сервисах
| Сервис | Лимит | Окно |
|---|---|---|
| GitHub API (неаутентифицированный) | 60 запросов | 1 час |
| GitHub API (аутентифицированный) | 5 000 запросов | 1 час |
| GitHub API (Enterprise Cloud) | 15 000 запросов | 1 час |
| Cloudflare API | 1 200 запросов | 5 минут |
| Cloudflare API per IP | 200 запросов | 1 секунда |
| OpenAI GPT-4o (Tier 1) | 500 запросов / 800 000 токенов | 1 минута |
| OpenAI GPT-4o (бесплатный) | 3 запроса / 40 000 токенов | 1 минута |
GitHub ограничивает неаутентифицированные запросы 60 в час, а аутентифицированные — 5 000 в час. Cloudflare устанавливает глобальный лимит 1 200 запросов за 5 минут на пользователя. OpenAI использует RPM и TPM для каждой модели: для GPT-4o на Tier 1 это 500 RPM и 800 000 TPM.
Практический пример: API с лимитом 60 RPM
Интеграция должна отправить 200 запросов, API разрешает 60 RPM. Если отправить все сразу — клиент столкнётся с ограничением. Правильный подход:
200 запросов → Очередь → Rate limiter (60 RPM) → API
Приложение ставит запросы в очередь, ограничивает скорость отправки, отслеживает ответы, учитывает Retry-After, повторяет временно отклонённые запросы, использует exponential backoff и контролирует параллельные операции.
Правовые аспекты rate limiting
Rate limiting — это не только технический, но и правовой инструмент. Сбор данных через парсинг без соблюдения лимитов может нарушать условия использования сайта и приводить к юридическим рискам.
Многие веб-сайты используют rate limiting, IP-блокировку и CAPTCHA для защиты от нежелательного парсинга. Если пользователь нарушает эти ограничения, это может рассматриваться как нарушение условий использования сервиса (Terms of Service) и повлечь юридические последствия.
Ключевые правовые аспекты:
- Условия использования (Terms of Service). Большинство API и веб-сайтов описывают допустимые лимиты запросов в своих условиях. Их нарушение может привести к блокировке аккаунта и, в отдельных случаях, к юридической ответственности.
- robots.txt. Этот файл сообщает правила обхода для краулеров, но не обеспечивает их принудительное исполнение. Даже если путь разрешён в robots.txt, rate limits и WAF могут отказать в доступе.
- Защита персональных данных. Если парсинг затрагивает персональные данные, могут применяться требования законодательства о защите данных (например, 152-ФЗ в России или GDPR в Европе).
- Нарушение работы сервиса. Чрезмерная нагрузка, вызванная игнорированием rate limiting, может привести к нарушению доступности сервиса для других пользователей, что создаёт дополнительные риски.
Рекомендации:
- Всегда проверяйте документацию API и условия использования перед интеграцией.
- Соблюдайте установленные лимиты и используйте рекомендованные интервалы.
- При необходимости увеличения лимитов обращайтесь к поставщику API официально.
- Не используйте обходные пути (ротация IP, подмена User-Agent) для обхода rate limiting — это может быть расценено как недобросовестное поведение.
Заключение
Rate limit — это механизм ограничения частоты или объёма использования API и цифровых ресурсов. Он помогает контролировать нагрузку, распределять ресурсы между клиентами и защищать сервис от чрезмерного количества запросов.
При превышении лимита HTTP API может вернуть 429 Too Many Requests. Чтобы корректно работать с такими ограничениями, приложение должно контролировать скорость и параллельность запросов, учитывать Retry-After, использовать retry с exponential backoff и jitter, а при необходимости — применять очередь.
Для реализации rate limiting используют Fixed Window, Sliding Window, Token Bucket и Leaky Bucket. Для ограничения одновременно выполняющихся операций — concurrency limiter. Выбор механизма зависит от требований конкретного API, характера нагрузки и допустимых bursts.
Читайте также
- REST API: что это, как работает и какие методы используются
- API: что это такое и как работает
- CAPTCHA: что это и как работает защита от ботов
- Веб-приложение: что это, виды и как работает
- Веб-сайт: что это, структура и виды
- Ping: что это и как проверить соединение
- Сервер: что это, виды и как работает
- Скрипт (Script): что это и как работает
- HTTPS: что это и как работает защита соединения
- IP-адрес: что это, виды и как узнать свой
FAQ: частые вопросы о rate limit
Что такое rate limit простыми словами?
Rate limit — это ограничение количества или частоты запросов к API за определённый период. Например, API может разрешать не более 100 запросов в минуту от одного API-ключа.
Что такое rate limiting?
Rate limiting — механизм контроля и ограничения потока запросов. Rate limit — установленное правило, а rate limiter — компонент, который это правило применяет.
Что означает rate limit в API?
Rate limit в API определяет, сколько запросов или другого ресурса клиент может использовать за период. Лимит может задаваться для IP, пользователя, API-ключа, endpoint.
Что означает ошибка 429?
HTTP 429 Too Many Requests означает, что клиент отправил слишком много запросов за период и сервер ограничил дальнейшие обращения. Если API возвращает Retry-After — его значение нужно учитывать при повторной попытке.
Почему API постоянно возвращает 429?
Причиной может быть превышение не только RPS или RPM. API может ограничивать токены, одновременные запросы, отдельные endpoint или общий лимит для нескольких клиентов с одним API-ключом.
Как исправить ошибку 429?
Снизьте частоту и параллельность запросов, учитывайте Retry-After, используйте retry с exponential backoff и jitter. Если ограничение связано с тарифом — может потребоваться изменение условий доступа.
Как избежать rate limit?
Полностью избежать ограничения невозможно. Но количество ошибок можно уменьшить с помощью очереди, ограничения RPS/RPM, контроля concurrency, кэширования, объединения запросов и корректной обработки 429.
Что делать, если Retry-After отсутствует?
Использовать собственную retry-политику с exponential backoff и jitter. Конкретную задержку выбирать с учётом документации API и характера операции.
Можно ли увеличить rate limit?
Иногда можно, но это зависит от конкретного API. Лимит может быть связан с тарифом, API-ключом, типом аккаунта. Если API предусматривает увеличение — это описано в документации.
Чем RPS отличается от QPS?
RPS (Requests Per Second) — количество запросов в секунду. QPS (Queries Per Second) — количество запросов в секунду. В разных системах эти термины могут использоваться немного по-разному.
Чем RPM отличается от RPS?
RPM показывает запросы в минуту, RPS — в секунду. 60 RPM не обязательно означает строго 1 запрос каждую секунду: распределение зависит от алгоритма и возможности создавать burst.
Чем rate limit отличается от quota?
Rate limit ограничивает скорость или частоту, quota — общий доступный объём за период. У одного API могут действовать оба ограничения одновременно.
Чем rate limit отличается от throttling?
Rate limit задаёт допустимую интенсивность, throttling — механизм ограничения или замедления потока. Термины близки и в документации могут использоваться рядом.
Какой алгоритм rate limiting выбрать?
Fixed Window — для простоты. Sliding Window — для равномерного контроля. Token Bucket — для контролируемых bursts. Leaky Bucket — для сглаживания потока. Concurrency limiter — для ограничения одновременных операций.